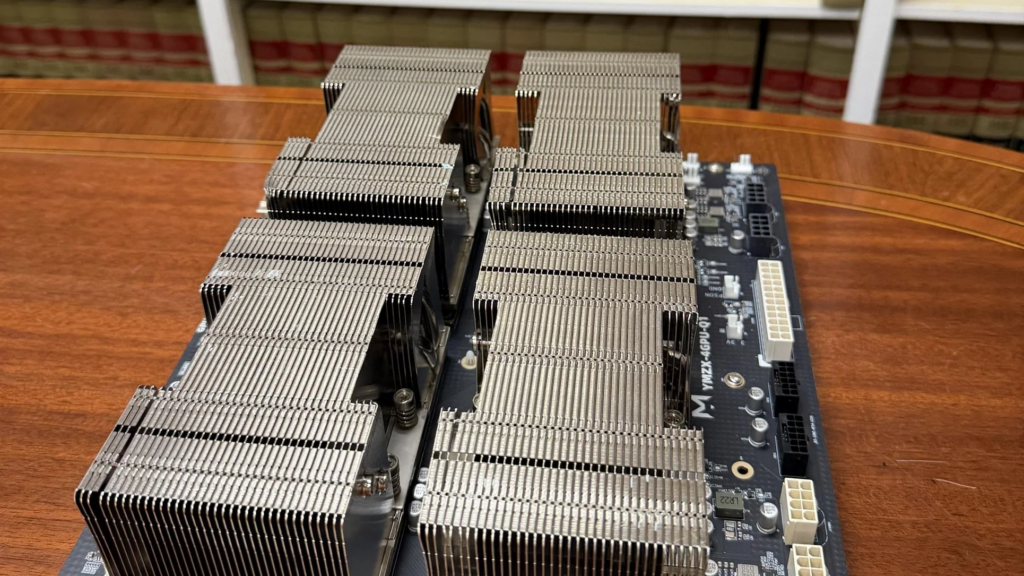

Pewien prawnik opublikował na platformie Reddit wpis dotyczący swojego prywatnego serwera AI, zbudowanego z ośmiu używanych procesorów graficznych Nvidia Tesla V100 z 2018 roku przeznaczonych do centrów danych. Wskazuje, że dzięki tej konstrukcji akta spraw, nad którymi pracuje, już nigdy nie muszą opuszczać biura. Składają się na nią dwie 4-kartowe płyty SXM2 NVLink, cztery przełączniki PEX i kable SlimSAS. Twórcy udało się uruchomić na niej otwarty model AI DeepSeek V4.1 Flash z pełnym wykorzystaniem pamięci kart graficznych, osiągając prędkość do 215 tokenów na sekundę. Czterokartowe płyty kosztowały go „tylko” około 2 400 dolarów za sztukę w momencie ich zakupu.
Patrzymy na praktyczny przykład wykorzystania używanego sprzętu z centrów danych – osiem kart Tesla V100-SXM2-32GB
Serwis Tom’s Hardware podaje, że osiem kart Tesla V100-SXM2-32GB, z których każda posiada 32 GB pamięci HBM2 o przepustowości 900 GB/s, podłącza się do gniazda SXM2 — mezzanine’owego złącza firmy Nvidia przeznaczonego dla procesorów graficznych w centrach danych — zamiast do gniazd PCIe i są one rozmieszczone na dwóch płytach bazowych.
Wewnątrz każdej płyty wszystkie cztery karty są połączone za pomocą NVLink — NVLink to bezpośrednie połączenie między procesorami graficznymi firmy Nvidia — zapewniając 128 GB na płytę, jednak obie płyty komunikują się wyłącznie przez interfejs PCIe. Każda płyta łączy się z hostem za pośrednictwem dwóch kart przełączających PEX (PLX) przy użyciu kabli SlimSAS, co daje łącznie cztery przełączniki, przy czym każdy przełącznik obsługuje dwa procesory graficzne z prędkością PCIe 3.0 x8 poprzez własne łącze uplink x16.
Warto zwrócić uwagę, że podane przez użytkownika ceny należą jednak już do przeszłości. Podaje się, że używane karty V100 SXM2 o pojemności 32 GB są obecnie wystawiane na eBayu za około 900 dolarów, czyli ponad dwukrotnie więcej niż około 400 dolarów za sztukę podane we wpisie, a kolejne oferty sugerują, że ceny nie przestają rosnąć.
System AI posiada już również inne niezbędne komponenty: płytę główną Gigabyte Threadripper Pro z 12-rdzeniowym procesorem 3945WX, 8 modułów pamięci 32 GB DDR4 RDIMM, jeden węzeł NUMA oraz dwa zasilacze o łącznej mocy 2 800 W, podłączone do oddzielnych, standardowych obwodów zasilających w biurze. Mamy jednak okazję przyjrzeć się praktycznem przykładowi wykorzystania używanego sprzętu z centrów danych jako niedrogiego sposobu na zgromadzenie dużej ilości szybkiej pamięci VRAM w jednym miejscu.

Ten system AI pozwala zapewnić prywatność w przypadkach, gdy pliki klientów nie mogą być przesyłane do chmury lub najnowszego modelu zewnętrznych firm
Użytkownik TumbleweedNew6515 wyjaśnia, że serwer jest obecnie wykorzystywany na co dzień do wstępnej obróbki akt spraw: odczytuje folder z dokumentacją, wyodrębnia fakty, daty i liczby, podsumowuje je oraz podejmuje pierwszą próbę rutynowego sporządzenia projektu dokumentu.
Dokumenty nigdy nie opuszczają biura. System analizuje folder z dokumentacją, wyodrębnia fakty, daty i liczby, sporządza podsumowanie i wykonuje wstępny szkic rutynowego projektu dokumentu. Nic nie opuszcza biura bez rzetelnej weryfikacji. Według moich szacunków 50–60% moich obecnych procesów związanych z LLM może teraz przebiegać na tym urządzeniu zamiast na modelach najnowszej generacji.
TumbleweedNew6515
Użytkownik może sterować systemem AI za pośrednictwem interfejsu w stylu Discorda przez SSH, w tym przypadku z komputera z systemem Windows. Na ten moment system obsługuje tylko jedno żądanie na raz. Do jego najważniejszych zalet należy jednak fakt, że pomaga on również zapewnić prywatność w przypadkach, gdy pliki klientów nie mogą być przesyłane do chmury lub najnowszego modelu firm odpowiedzialnych za rozwój sztucznej inteligencji.



0 komentarzy