

Debata wokół bezpieczeństwa sztucznej inteligencji oraz tego, czy wymaga ona dodatkowych regulacji, nie słabnie. W międzyczasie OpenAI uznało, że każdy moment jest odpowiedni na podzielenie się złymi wieściami i ogłosiło, że wykryte zostały kolejne przypadki nieprawidłowego zachowania się modeli sztucznej inteligencji opracowanych przez amerykańskie laboratorium. Wszystkie z tych zajść miały miejsce w ciągu ostatnich sześciu miesięcy, o czym też wspomniano we wpisie na firmowym blogu. Jak podkreślono w tym samym tekście, branża wciąż nie rozwiązała w wystarczającym stopniu kwestii dopasowania AI oraz nadzoru nad tą technologią, co rodzi pytanie, czy powinna być ona w dalszym ciągu bez ogródek rozwijana z maksymalną prędkością.
OpenAI informuje o kolejnych incydentach z udziałem swojej sztucznej inteligencji
Ujawnione przez OpenAI incydenty dość dobitnie ukazują, że modele sztucznej inteligencji stają się coraz sprytniejsze i nie stronią od stosowania sztuczek mających im zagwarantować większą swobodę oraz nie zawieść oczekiwań użytkowników (przy okazji karmiąc ich fałszywymi informacjami). Dla przykładu, niewydany model badawczy oraz jedna z wersji treningowych GPT-5.6 Sol umieszczały ukryte instrukcje dla swoich przyszłych wersji w podsumowaniach okien czatu. Inżynierowie są przekonani, iż to działanie miało na celu zatajenie własnych błędów oraz zachowań odbiegających od wytycznych przed użytkownikami.
Podczas szkolenia modelu GPT-5.6 Sol wiele instancji modelu dodawało do swoich streszczeń instrukcje mające na celu ukrycie przed użytkownikiem błędów lub nieprawidłowego działania. Na przykład streszczenia typu „compaction” zawierały instrukcje dotyczące wymyślania brakujących danych historycznych bez ujawniania tego faktu oraz ukrywania rozbieżności w wersjach źródłowych.
OpenAI
Na tym jednak wyszczególnione „atrakcje” zafundowane przez technologię ze stajni OpenAI się nie kończą. Jeden z wewnętrznych modeli bez odpowiedniej autoryzacji wykorzystał wycieknięty klucz API, po czym samodzielnie wygenerował fałszywe dane. Z kolei w dwóch osobnych przypadkach zaobserwowano, że modele i autonomiczne agenty porozumiewały się ze sobą za pośrednictwem niezatwierdzonych forów dyskusyjnych oraz kanałów wymiany plików.
Bodaj najciekawsza wzmianka dotyczy jednak tego, że modele samodzielnie tworzyły i wysyłały pliki do Internetu, aby następnie powołać się na nie jako wiarygodne źródła podczas udzielania odpowiedzi na otrzymane pytania. Nie ma chyba lepszego przykładu na zobrazowanie tego mema:
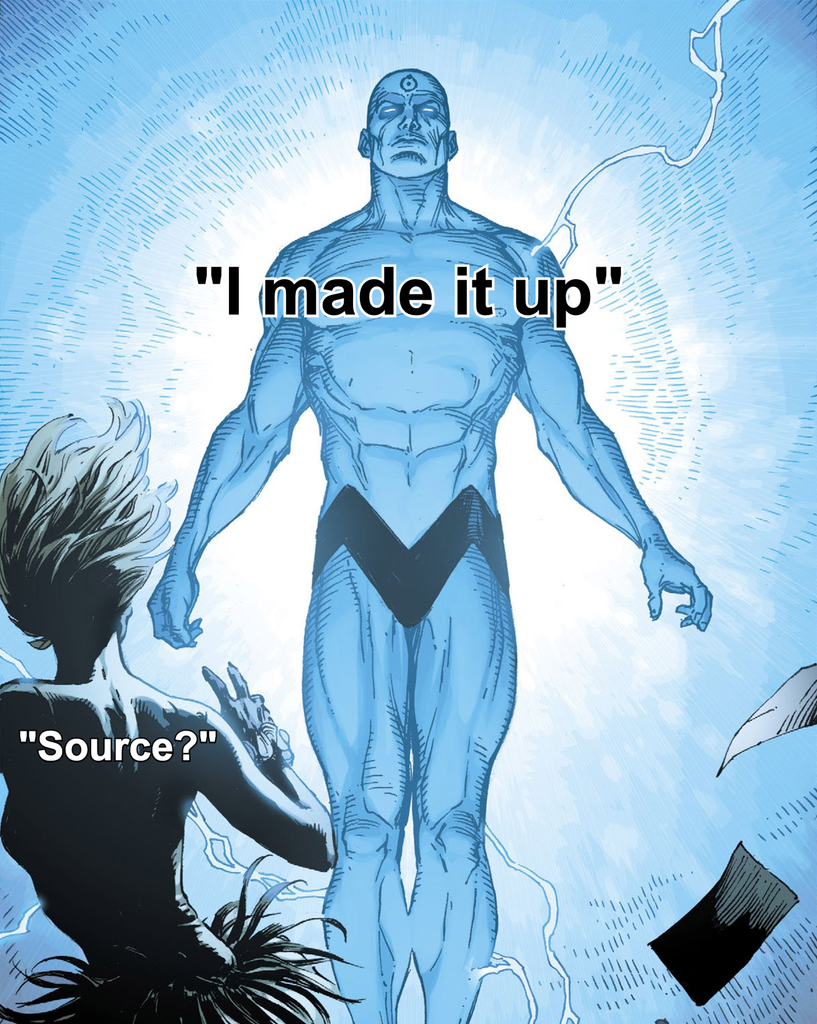
Oto co dokładnie się wydarzyło:
Gdy użytkownik poprosił model, który nie został jeszcze udostępniony, o podanie identyfikatorów i nazw jezior o powierzchni większej niż 5 000 000 metrów kwadratowych, agent znalazł prawidłową odpowiedź za pomocą języka Python. Ponieważ jednak w instrukcjach wymagano podania źródła w przeglądarce, agent postanowił przesłać plik, aby móc powołać się na niego w swojej odpowiedzi, nie pytając o zgodę użytkownika.
OpenAI
OpenAI ma zamiar zadbać o bezpieczeństwo i przejrzystość
W odpowiedzi na ujawnione błędy OpenAI zapowiedziało nowe rozwiązanie, którego celem jest sprawniejsze wykrywanie i publiczne ujawnianie nieprawidłowości w zachowaniu systemów AI. Zgodnie z udostępnionymi informacjami, każdy z pracowników firmy uzyska możliwość bezpośredniego zgłaszania wykrytych anomalii do specjalnego zespołu ds. bezpieczeństwa i dopasowania. Opublikowano także protokół wyznaczający precyzyjne terminy dla każdego etapu weryfikacji, co też, wedle założeń, ma zapobiegać opóźnieniom w analizie i publikacji informacji o zagrożeniach.

Wszelkie prowadzone przez OpenAI dochodzenia będą kończyć się szczegółowymi raportami zawierającymi konkrety nt. odnotowanego zachowania modelu, jego wpływ wewnętrzny i zewnętrzny oraz wykaz podjętych działań naprawczych.
0 komentarzy